Is NetBrain あなたとあなたの組織に最適ですか?
ホワイトペーパー「ネットワークのダウンタイムを毎年半分に削減 - 現代のネットワーク運用における AI ベースの自動化の約束」をダウンロードし、決定に役立つ簡単なチェックリストを確認してください。

問題はデータそのものではなく、それをどう使うかです。
長年にわたり、ネットワーク チームはダウンタイムに関する洞察を欠いていましたが、…
さらなるテレメトリ。
より多くのダッシュボード。
さらなるアラート。
...
しかし、解決までの平均時間(MTTR)は目立った改善が見られません。依然として数時間に及ぶ作業が続き、同じインシデントが再発します。その原因の多くは、設定のずれ、ツールの断片化、人手によるトラブルシューティングなどです。
本当のギャップはデータではありません。部族の知識と手作業のプロセスを、再利用可能なインテリジェンスと繰り返し可能な自動化に変換することにあります。
ネットワーク監視ツールは、何か問題があることを警告します。
しかし、それらはどこで、なぜ発生したのか、そしてネットワーク全体で同様の事象をどのように見つけるかを伝えるにとどまります。残念ながら、今日の手作業によるNetOpsプロセスでは、コンテキストの抽出、パスの追跡、構成の比較、そして問題が以前に解決されたかどうか、そして誰が解決したかの調査など、熟練したスタッフが限られているため、これは不可能です。この状況は、長期にわたる障害、インシデントの再発、そして解決サイクルの遅延につながっています。
ここで自動化の出番となる。自動化の目的は、複雑化するネットワークにおける運用管理のギャップを埋めることだ。ネットワークは、物理インフラ、ハイブリッド/マルチクラウド、SD-WAN、Kubernetesのような動的なワークロードなど、多岐にわたり、多くの場合、その上にアプリケーション間の依存関係が積み重なっていく。自動化がなければ、ダウンタイムは解消されない。しかし、自動化だけでは導入や活用が難しい。自動化スクリプトやノーコード自動化でさえ、習得に時間がかかり、導入を阻害する要因となっている。
エージェントAIを搭載し、 NetBrainの第5世代プラットフォーム ペアの intent-based automation エージェント型AIとリアルタイムデジタルツイン技術を活用することで、このAIは博士号レベルのネットワークエンジニアのように、問題の診断、脆弱性の評価、ネットワーク変更の安全な実行を行います。エンジニアから学習することで、何千ものタスクを機械のスピードでオーケストレーションし、結果が出るたびに知識を蓄積していきます。
将来を見据えたネットワーク自動化は、可視性重視から自動化重視への移行から始まります。
これは1日あたり why NetBrainの創設者 自動化ファーストの運用モデルを概説したホワイトペーパーを執筆 測定可能な目標に焦点を当てる: 体系的な方法でネットワークのダウンタイムを毎年削減し、 intent-based automation―AIによって加速される。
目標は、あらゆる問題解決にかかる平均時間とチケット総数を削減することで、ネットワークのダウンタイムを目に見える形で削減することです。現代の企業では、時間単位およびインシデント単位のコストが莫大なため、その重要性は極めて高いと言えます。
ダウンタイムを削減すると、次のような結果が得られます。
以下の方法は、両方を体系的に実行するように設計されています。
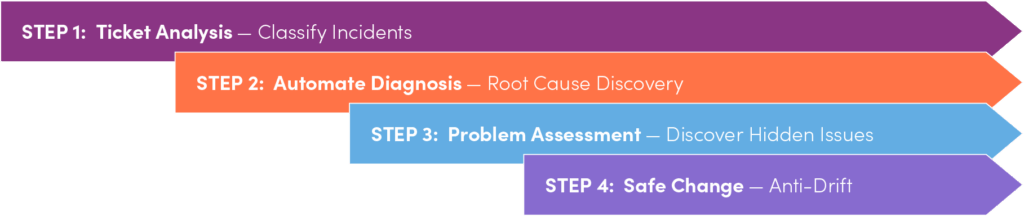
最も論理的な出発点は、既存のチケットを分析することです。あらゆる組織には、業務改善のための素材、つまりチケット履歴が既に存在します。
医師が患者の記録を分析するのと同じように、自動化とAIは過去のチケットを分析し、将来のインシデントをトラブルシューティングするための基盤を構築します。過去のインシデントを分析することで、チームは最も時間がかかり、最も頻繁に発生するチケットの種類を特定できます。目標は継続的な改善とコスト削減です。 MTTR.
Intent-based automation 再利用可能 runbook診断を「部族の知識」から運用資産へと移行します。
包括的な自動診断への道筋には、「シフトレフト」戦略、すなわち診断業務をエンジニアからAIへと体系的に移行することが必要です。これは、インテリジェントで実行可能なAIを構築することで実現されます。 runbook各インシデントの種類ごとに。これらは runbook自動化ノード(コマンド、設定、評価、AI生成サマリーなど)を透明な「ホワイトボックス」システムに統合します。AIはワークフローをオーケストレーションし、出力から推論し、根本原因を特定することで、人間の専門知識と機械の精度を融合させます。
この体系的なアプローチにより、診断のスピードと範囲が飛躍的に向上し、99%の問題解決が現実的な目標となります。また、同じ資産を活用して、人間の介入なしに同様の精度を実現する、完全自律型の「ブラックボックス」AIを構築することも可能です。
それぞれの失敗から学ばなければ、強力な診断を行ってもインシデントを減らすことはできません。
事後検証では、チームは根本原因を評価に体系化し、環境全体で実行して「ネットワークの他の場所にもこの問題のインスタンスがありますか?」という単純な質問に答えます。
時間が経つにつれて、業務は事後対応型の消火活動から事前対応型の検出へと移行し、業界全体の停止に関する知識を自社のネットワークで活用して停止を防止します。
停電を減らしたいなら、ドリフトを最小限に抑える必要があります。
実用的なアプローチは、変更が発生する前と後に、変更を「理想的な」期待値に照らして検証することです。そうすることで、ドリフトが早期に検出され、気づかないうちにリスクに蓄積されることがなくなります。
ドリフト制御が実施されると、チームは頻繁な変更ワークフローを標準化し始めることができるため、繰り返しの変更はより安全、より高速、より一貫したものになります。
最新世代のネットワーク自動化は、AI を常時稼働のエンジニアとして使用してデジタル ツイン基盤上に構築され、大規模な自動化のオーケストレーション、結果の解釈、説明可能性を維持しながらチームの迅速な行動の支援など、成果を加速します。
言い換えれば、AI は運用ワークフローを置き換えるのではなく、ワークフローを加速するのです。
ネットワーク自動化は、チームがデータ不足だから失敗するわけではありません。静的なダッシュボードやマニュアルに囚われ、データから洞察が得られないから失敗します。 runbook、そして個人の経験。